

Su estilo, no solo sus palabras
Un perfil de estilo de toda la exportación, y cada burbuja, sticker, GIF, respuesta y reacción se reproduce ante el modelo como una llamada a herramienta.
Cómo funciona
Habla con las personas que echas de menos.
Exporta un chat de Telegram o WhatsApp. Un LLM lo continúa al estilo de una persona, con sus burbujas, stickers, GIF, reacciones y voz. En tu ordenador, con cualquier modelo, y sin conexión si quieres.
Un perfil de estilo de toda la exportación, y cada burbuja, sticker, GIF, respuesta y reacción se reproduce ante el modelo como una llamada a herramienta.
Cómo funciona
Los chats se quedan en tu carpeta de datos. Con un modelo local y el modo sin conexión activado, la app rechaza cada solicitud que saldría de tu ordenador.
Sin conexión y privacidad
Importa más de 120.000 mensajes y 30.000 archivos con progreso en vivo. Una reimportación se detecta por los mensajes, antes de subir ningún medio.
Exportaciones grandes
Una biblioteca de medios que describe lo enviado y transcribe la voz, en el orden que elijas, y que puedes detener en cualquier momento.
Fotos y voz
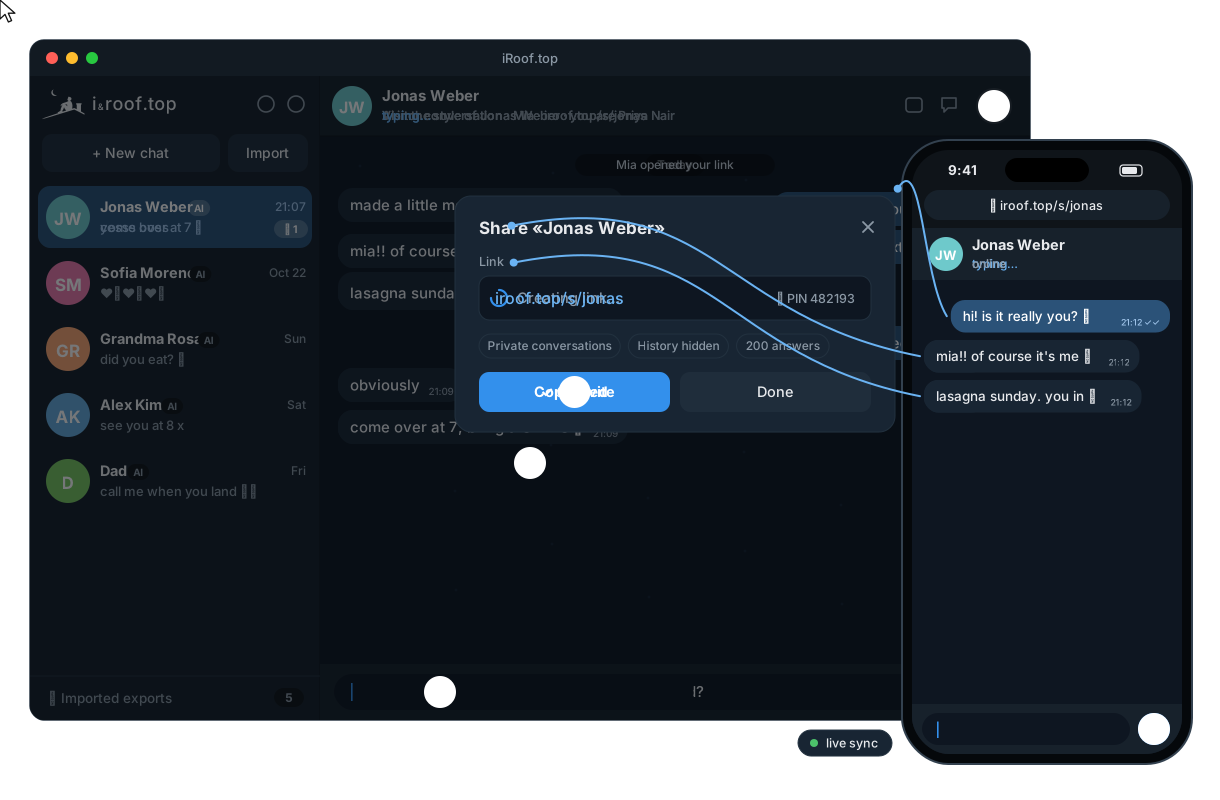
Deja que un amigo hable con el personaje en /s/nombre, con PIN y límites, en tu Wi‑Fi o en nombre.iroof.top.
Enlaces para compartir
Los mensajes de los visitantes llegan a tu grupo de Telegram. Responde tú, o deja que la IA conteste tras una cuenta atrás.
Telegram
OpenAI, OpenRouter, Gemini, Ollama, LM Studio, llama.cpp… y herramientas MCP por Streamable HTTP o stdio.
Herramientas MCP
El JSON exacto que se envía al modelo está a un clic, con su tamaño, el presupuesto del historial y los tokens usados.
Qué hay en la ventana
Un servidor en Rust con la interfaz web dentro, apps de escritorio para macOS, Windows y Linux, Homebrew y una imagen de Docker.
Instalar
brew install --cask irooftop/tap/irooftop   # macOS
# Windows and Linux: direct downloads under "Download the app" above
# Open the app, then Settings → model and key → Testbrew install irooftop/tap/rooftop
export OPENAI_API_KEY=… # OpenRouter by default, any OpenAI-compatible API works
rooftop # http://127.0.0.1:8080, then drop an export onto the pagedocker run -d -p 8080:8080 -e OPENAI_API_KEY=… \
-v rooftop-data:/data ghcr.io/irooftop/rooftopcargo install rooftop # Rust ≥ 1.88
OPENAI_API_KEY=… rooftopollama pull qwen3 # any local model with tool calling
OPENAI_BASE_URL=http://localhost:11434/v1 OPENAI_MODEL=qwen3 rooftop --offlineLuego, tres pasos: exporta un chat desde Telegram Desktop o WhatsApp, arrastra la carpeta, el .zip o el .txt a la página y pulsa New chat para elegir quién hace de IA: la otra persona, o tú mismo. ¿No tienes un chat a mano? Prueba los ficticios: rooftop --import ./examples/telegram. (Los nombres de los botones de la app están en inglés, como la propia app.)
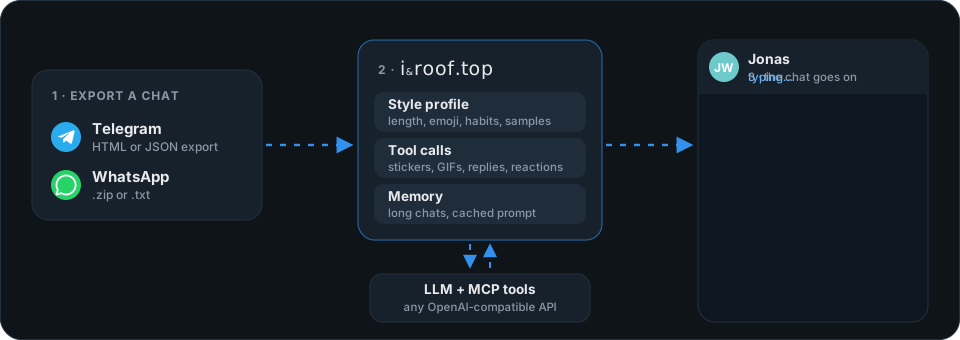
El export se lee una sola vez, en tu ordenador. En cada respuesta el modelo recibe un prompt del sistema con el perfil de estilo, tus notas y las descripciones de los medios, y después la parte más reciente del chat que cabe en el presupuesto de historial. Las partes antiguas se pliegan en un resumen breve, y el personaje sigue pudiendo buscarlas. El modelo responde con llamadas a herramientas (send_message, send_sticker, react…), que se convierten en burbujas, stickers y reacciones. Más →
| Red | |
|---|---|
| Importar, el perfil de estilo, la búsqueda y el almacenamiento | ninguna: todo ocurre en tu ordenador |
| Una respuesta, un resumen de memoria | el endpoint del modelo que elijas, y nada más |
| Describir medios, transcribir voz | el modelo de medios, solo cuando pulsas Describe |
| Enlaces para compartir por internet, Telegram | solo si los activas; el modo sin conexión los desactiva |
Cualquier modelo de chat con llamadas a herramientas detrás de un endpoint /chat/completions compatible con OpenAI. Los modelos más grandes imitan mejor un estilo. Para Describe en la biblioteca de medios, el modelo de medios también debe aceptar imágenes (y audio para los mensajes de voz). Test en Ajustes te dice con palabras sencillas qué falla, por ejemplo una clave rechazada o un modelo desconocido.
Nada con un modelo local. Con un modelo en la nube pagas a tu proveedor por token: una respuesta cuesta aproximadamente un presupuesto de historial de entrada (120.000 caracteres ≈ 34 k tokens por defecto; el prompt está pensado para ser cacheable, así que los proveedores con caché de prompts cobran la mayor parte a la tarifa cacheada) más unas pocas llamadas cortas a herramientas. Reduce el presupuesto en Ajustes para pagar menos por respuesta.
No. Las exportaciones de más de 120.000 mensajes y 13 GB de medios se importan bien, desde el navegador o con rooftop --import <carpeta>. La búsqueda y el presupuesto de historial mantienen igual de grande el prompt de cada respuesta, por largo que sea el chat.
Sí, con un enlace para compartir: en tu Wi‑Fi, o por internet en nombre.iroof.top, con PIN y límites de mensajes. Los visitantes solo ven el chat: nada de ajustes, notas, prompts ni otros chats.
Una nota sobre el cuidado
Esto sirve para estar cerca de personas que están lejos. El personaje se mantiene en su papel, pero responde con honestidad si preguntas sinceramente si hablas con una IA, y responde con cuidado si parece que estás en apuros.