

Jej styl, nie tylko słowa
Profil stylu zbudowany z całego eksportu; każdy dymek, naklejka, GIF, odpowiedź i reakcja jest odtwarzana modelowi jako wywołanie narzędzia.
Jak to działa
Rozmawiaj z ludźmi, za którymi tęsknisz.
Wyeksportuj czat z Telegrama lub WhatsAppa, a LLM poprowadzi go dalej w stylu danej osoby, z jej dymkami, naklejkami, GIF-ami, reakcjami i głosem. Na Twoim komputerze, z dowolnym modelem, a jeśli chcesz – offline.
Profil stylu zbudowany z całego eksportu; każdy dymek, naklejka, GIF, odpowiedź i reakcja jest odtwarzana modelowi jako wywołanie narzędzia.
Jak to działa
Czaty zostają w Twoim folderze danych. Z lokalnym modelem i włączonym trybem offline aplikacja odrzuca każde żądanie, które opuściłoby Twój komputer.
Offline i prywatność
Ponad 120 000 wiadomości i 30 000 plików importowanych z podglądem postępu na żywo. Ponowny import jest rozpoznawany po wiadomościach, zanim zostanie przesłane jakiekolwiek medium.
Duże eksporty
Biblioteka mediów opisuje wysłane rzeczy i transkrybuje głos, w kolejności, którą wybierzesz, z możliwością zatrzymania w dowolnym momencie.
Zdjęcia i głos
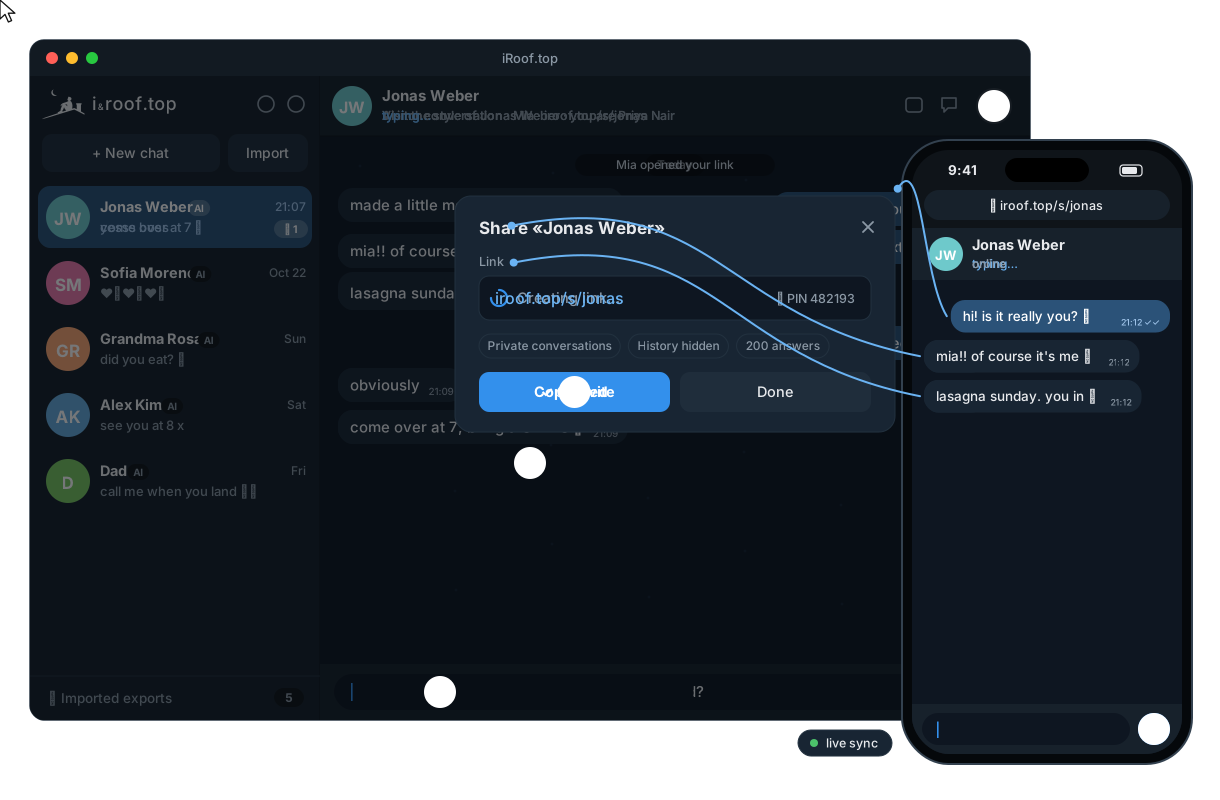
Pozwól przyjacielowi rozmawiać z personą pod /s/nazwa, z PIN-em i limitami, w Twojej sieci Wi‑Fi lub pod nazwa.iroof.top.
Linki udostępniania
Wiadomości od odwiedzających trafiają do Twojej grupy na Telegramie. Odpowiadaj sam albo pozwól AI odpowiedzieć po odliczaniu.
Telegram
OpenAI, OpenRouter, Gemini, Ollama, LM Studio, llama.cpp… oraz narzędzia MCP przez Streamable HTTP lub stdio.
Narzędzia MCP
Dokładny JSON wysłany do modelu jest o jedno kliknięcie dalej, z rozmiarem, budżetem historii i zużytymi tokenami.
Co jest w oknie
Serwer w Rust z wbudowanym interfejsem webowym, aplikacje desktopowe dla macOS, Windows i Linux, Homebrew oraz obraz Docker.
Instalacja
brew install --cask irooftop/tap/irooftop   # macOS
# Windows and Linux: direct downloads under "Download the app" above
# Open the app, then Settings → model and key → Testbrew install irooftop/tap/rooftop
export OPENAI_API_KEY=… # OpenRouter by default, any OpenAI-compatible API works
rooftop # http://127.0.0.1:8080, then drop an export onto the pagedocker run -d -p 8080:8080 -e OPENAI_API_KEY=… \
-v rooftop-data:/data ghcr.io/irooftop/rooftopcargo install rooftop # Rust ≥ 1.88
OPENAI_API_KEY=… rooftopollama pull qwen3 # any local model with tool calling
OPENAI_BASE_URL=http://localhost:11434/v1 OPENAI_MODEL=qwen3 rooftop --offlinePotem trzy kroki: wyeksportuj czat z Telegram Desktop lub WhatsAppa, przeciągnij folder, .zip albo .txt na stronę i naciśnij New chat, aby wybrać, kto gra AI: druga osoba czy Ty sam. Nie masz pod ręką własnego czatu? Wypróbuj fikcyjne: rooftop --import ./examples/telegram. (Nazwy przycisków w aplikacji są po angielsku, tak jak sama aplikacja.)
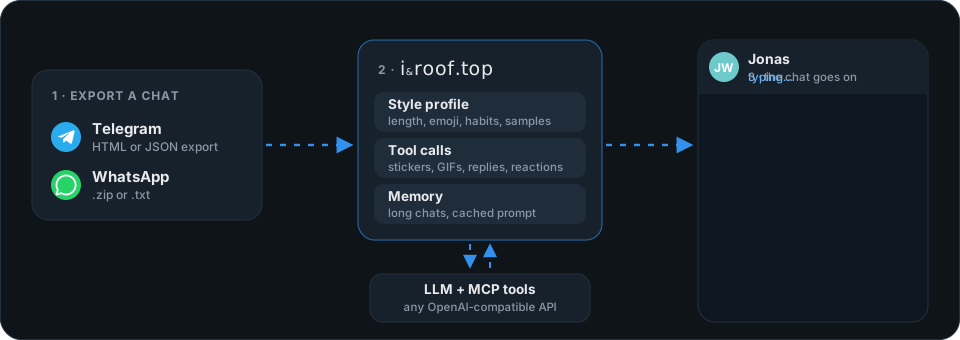
Eksport jest czytany raz, na Twoim komputerze. Przy każdej odpowiedzi model dostaje prompt systemowy z profilem stylu, Twoimi notatkami i opisami mediów, a potem najnowszą część czatu, która mieści się w budżecie historii. Starsze części są zwijane w krótką pamięć, a persona nadal może ich szukać. Model odpowiada wywołaniami narzędzi (send_message, send_sticker, react…), które stają się dymkami, naklejkami i reakcjami. Więcej →
| Sieć | |
|---|---|
| Import, profil stylu, wyszukiwanie, przechowywanie | brak: wszystko dzieje się na Twoim komputerze |
| Jedna odpowiedź, podsumowanie pamięci | wyłącznie endpoint modelu, który wybierzesz |
| Opisywanie mediów, transkrypcja głosu | model mediów, tylko gdy naciśniesz Describe |
| Linki udostępniania przez internet, Telegram | tylko jeśli je włączysz; tryb offline je wyłącza |
Dowolnego modelu czatu z wywoływaniem narzędzi za endpointem /chat/completions zgodnym z OpenAI. Większe modele lepiej naśladują styl. Do Describe w bibliotece mediów model mediów musi też przyjmować obrazy (a do wiadomości głosowych – dźwięk). Test w ustawieniach prostymi słowami mówi, co jest nie tak, np. odrzucony klucz albo nieznany model.
Nic przy lokalnym modelu. Przy modelu w chmurze płacisz dostawcy za tokeny: jedna odpowiedź kosztuje mniej więcej tyle, ile budżet historii na wejściu (domyślnie 120 000 znaków ≈ 34 tys. tokenów; prompt jest zbudowany tak, by mógł być buforowany, więc dostawcy z buforowaniem promptów większość rozliczają po cenie z bufora), plus kilka krótkich wywołań narzędzi. Zmniejsz budżet w ustawieniach, aby płacić mniej za odpowiedź.
Nie. Eksporty z ponad 120 000 wiadomości i 13 GB mediów importują się bez problemu, z przeglądarki albo poleceniem rooftop --import <folder>. Wyszukiwanie i budżet historii utrzymują rozmiar promptu każdej odpowiedzi na tym samym poziomie, bez względu na długość czatu.
Tak, przez link udostępniania: w Twojej sieci Wi‑Fi albo przez internet pod nazwa.iroof.top, z PIN-em i limitami wiadomości. Odwiedzający widzą tylko czat: bez ustawień, notatek, promptów i innych czatów.
Słowo o trosce
To ma pomagać być blisko ludzi, którzy są daleko. Persona zostaje w roli, ale odpowie szczerze, jeśli naprawdę zapytasz, czy rozmawiasz z AI, a gdy wydasz się w potrzebie, odpowie z troską.