

Il suo stile, non solo le sue parole
Un profilo di stile ricavato dall'intera esportazione, e ogni bolla, sticker, GIF, risposta e reazione viene riprodotta al modello come chiamata a uno strumento.
Come funziona
Parla con le persone che ti mancano.
Esporta una chat di Telegram o WhatsApp e un LLM la continua nello stile di una persona, con le sue bolle, sticker, GIF, reazioni e voce. Sul tuo computer, con il modello che preferisci, anche offline se vuoi.
Un profilo di stile ricavato dall'intera esportazione, e ogni bolla, sticker, GIF, risposta e reazione viene riprodotta al modello come chiamata a uno strumento.
Come funziona
Le chat restano nella tua cartella dei dati. Con un modello locale e la modalità offline attiva, l'app rifiuta ogni richiesta che lascerebbe il tuo computer.
Offline e privacy
Oltre 120.000 messaggi e 30.000 file vengono importati con l'avanzamento in tempo reale. Un'importazione ripetuta viene riconosciuta dai messaggi, prima che venga caricato qualsiasi media.
Esportazioni grandi
Una libreria di media che descrive ciò che è stato inviato e trascrive la voce, nell'ordine che scegli, interrompibile in ogni momento.
Foto e voce
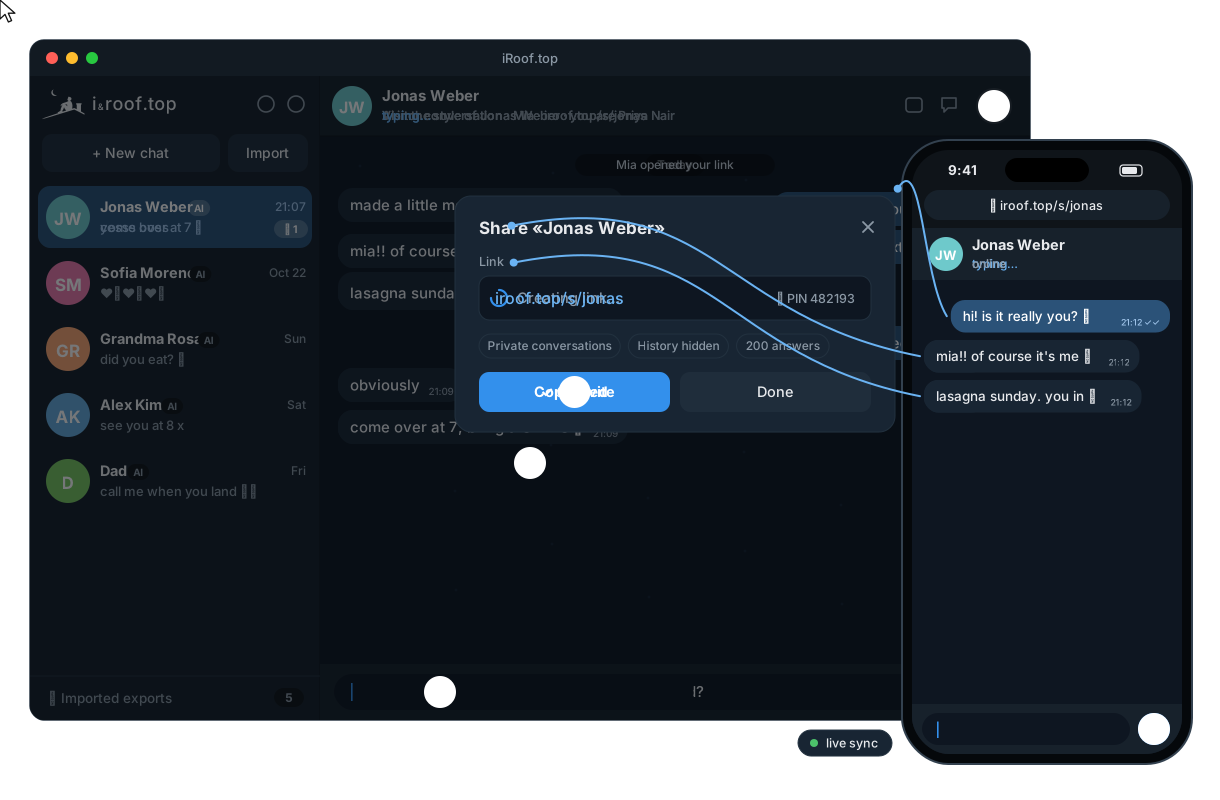
Lascia che un amico parli con il personaggio su /s/nome, con PIN e limiti, sul tuo Wi‑Fi o su nome.iroof.top.
Link di condivisione
I messaggi dei visitatori arrivano al tuo gruppo Telegram. Rispondi tu, o lascia che l'IA risponda dopo un conto alla rovescia.
Telegram
OpenAI, OpenRouter, Gemini, Ollama, LM Studio, llama.cpp… e strumenti MCP via Streamable HTTP o stdio.
Strumenti MCP
Il JSON esatto inviato al modello è a un clic di distanza, con la sua dimensione, il budget della cronologia e i token usati.
Cosa c'è nella finestra
Un server Rust con l'interfaccia web incorporata, app desktop per macOS, Windows e Linux, Homebrew e un'immagine Docker.
Installa
brew install --cask irooftop/tap/irooftop   # macOS
# Windows and Linux: direct downloads under "Download the app" above
# Open the app, then Settings → model and key → Testbrew install irooftop/tap/rooftop
export OPENAI_API_KEY=… # OpenRouter by default, any OpenAI-compatible API works
rooftop # http://127.0.0.1:8080, then drop an export onto the pagedocker run -d -p 8080:8080 -e OPENAI_API_KEY=… \
-v rooftop-data:/data ghcr.io/irooftop/rooftopcargo install rooftop # Rust ≥ 1.88
OPENAI_API_KEY=… rooftopollama pull qwen3 # any local model with tool calling
OPENAI_BASE_URL=http://localhost:11434/v1 OPENAI_MODEL=qwen3 rooftop --offlinePoi tre passaggi: esporta una chat da Telegram Desktop o WhatsApp, trascina la cartella, lo .zip o il .txt nella pagina e premi New chat per scegliere chi fa l'IA: l'altra persona, o tu. Non hai una chat a portata di mano? Prova quelle fittizie: rooftop --import ./examples/telegram. (I nomi dei pulsanti dell'app sono in inglese, come l'app stessa.)
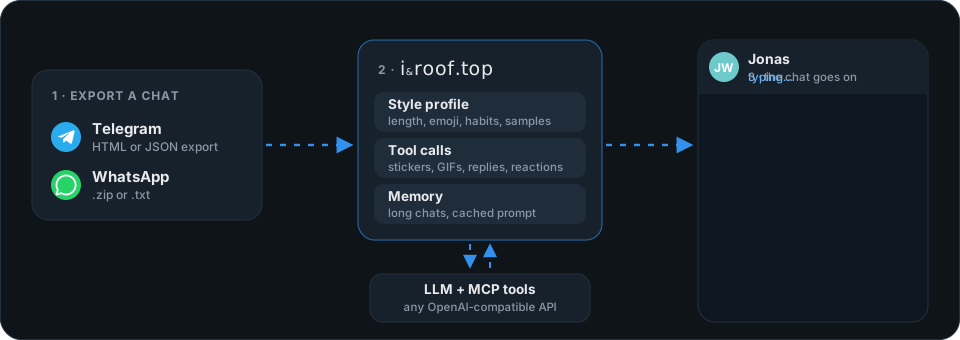
L'esportazione viene letta una sola volta, sul tuo computer. A ogni risposta il modello riceve un prompt di sistema con il profilo di stile, le tue note e le descrizioni dei media, poi la parte più recente della chat che sta nel budget della cronologia. Le parti più vecchie vengono compresse in una memoria breve, e la persona può comunque cercarle. Il modello risponde con chiamate a strumenti (send_message, send_sticker, react…), che diventano bolle, sticker e reazioni. Altro →
| Rete | |
|---|---|
| Importazione, profilo di stile, ricerca, archiviazione | nessuna: tutto avviene sul tuo computer |
| Una risposta, un riassunto della memoria | solo l'endpoint del modello che scegli |
| Descrivere i media, trascrivere la voce | il modello dei media, solo quando premi Describe |
| Link di condivisione via internet, Telegram | solo se li attivi; la modalità offline li disattiva |
Un modello di chat con chiamate a strumenti dietro un endpoint /chat/completions compatibile con OpenAI. I modelli più grandi imitano meglio uno stile. Per Describe nella libreria dei media, il modello dei media deve anche accettare immagini (e audio per i messaggi vocali). Test nelle impostazioni spiega con parole semplici cosa non va, per esempio una chiave rifiutata o un modello sconosciuto.
Niente con un modello locale. Con un modello nel cloud paghi il fornitore a token: una risposta costa circa quanto un budget della cronologia in ingresso (120.000 caratteri ≈ 34 mila token di default; il prompt è costruito per essere memorizzabile nella cache, quindi i fornitori con cache dei prompt addebitano gran parte al prezzo in cache), più alcune brevi chiamate a strumenti. Riduci il budget nelle impostazioni per pagare meno a risposta.
No. Le esportazioni con più di 120.000 messaggi e 13 GB di media si importano senza problemi, dal browser o con rooftop --import <cartella>. La ricerca e il budget della cronologia mantengono la stessa dimensione del prompt a ogni risposta, per quanto lunga sia la chat.
Sì, con un link di condivisione: sul tuo Wi‑Fi, o via internet su nome.iroof.top, con PIN e limiti di messaggi. I visitatori vedono solo la chat: niente impostazioni, note, prompt o altre chat.
Una nota sulla cura
Questo serve a restare vicini a persone lontane. La persona resta nel suo ruolo, ma risponde con onestà se chiedi sinceramente se stai parlando con un'IA, e risponde con cura se sembri in difficoltà.