

O estilo dela, não só as palavras
Um perfil de estilo tirado da exportação inteira, e cada bolha, figurinha, GIF, resposta e reação é reproduzido ao modelo como uma chamada de ferramenta.
Como funciona
Fale com as pessoas que você sente falta.
Exporte uma conversa do Telegram ou do WhatsApp, e um LLM a continua no estilo de uma pessoa, com as bolhas, figurinhas, GIFs, reações e a voz dela. No seu computador, com qualquer modelo, e offline se preferir.
Um perfil de estilo tirado da exportação inteira, e cada bolha, figurinha, GIF, resposta e reação é reproduzido ao modelo como uma chamada de ferramenta.
Como funciona
As conversas ficam na sua pasta de dados. Com um modelo local e o modo offline ativado, o app recusa qualquer pedido que sairia do seu computador.
Offline e privacidade
Mais de 120.000 mensagens e 30.000 arquivos são importados com progresso ao vivo. Uma reimportação é reconhecida pelas mensagens, antes de qualquer mídia ser enviada.
Exportações grandes
Uma biblioteca de mídia que descreve o que foi enviado e transcreve a voz, na ordem que você escolher, podendo ser interrompida a qualquer momento.
Fotos e voz
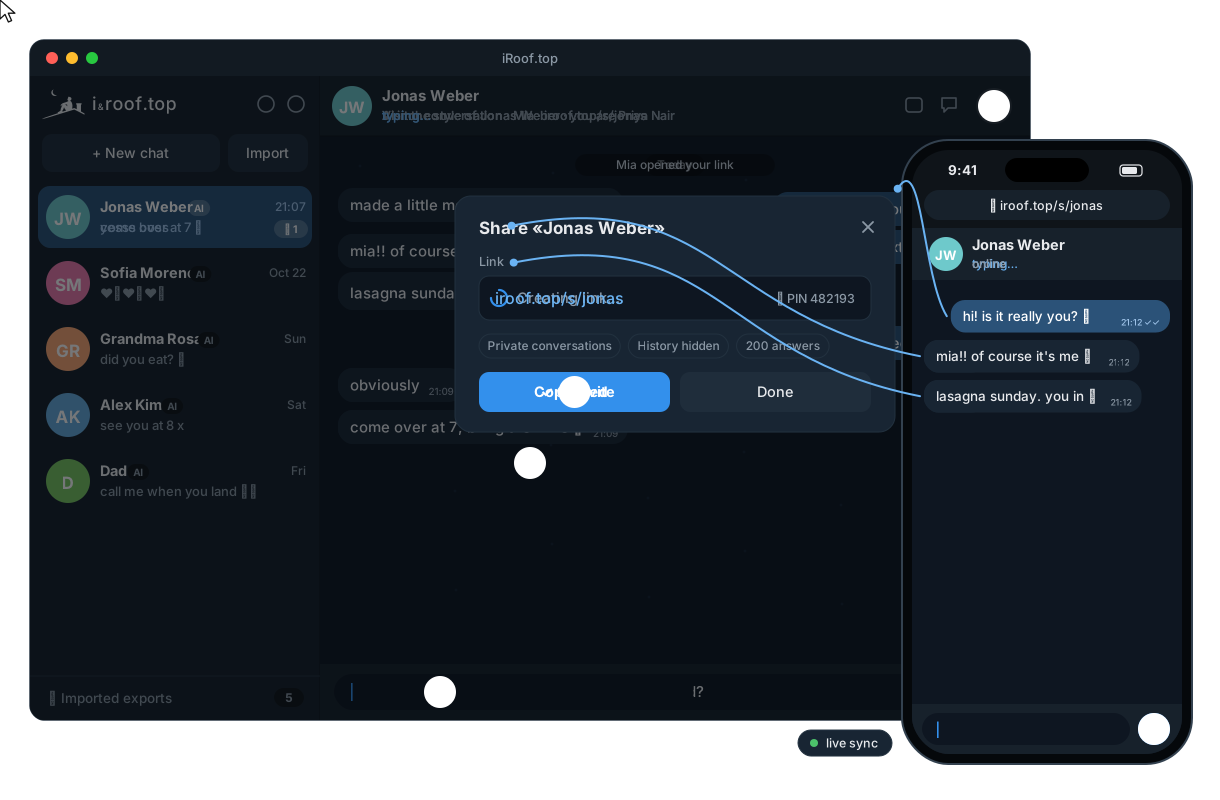
Deixe um amigo conversar com a persona em /s/nome, com PIN e limites, no seu Wi‑Fi ou em nome.iroof.top.
Links de compartilhamento
As mensagens dos visitantes chegam ao seu grupo do Telegram. Responda você mesmo, ou deixe a IA responder depois de uma contagem regressiva.
Telegram
OpenAI, OpenRouter, Gemini, Ollama, LM Studio, llama.cpp… e ferramentas MCP por Streamable HTTP ou stdio.
Ferramentas MCP
O JSON exato enviado ao modelo está a um clique, com o tamanho, o orçamento do histórico e os tokens usados.
O que há na janela
Um servidor em Rust com a interface web dentro, apps de desktop para macOS, Windows e Linux, Homebrew e uma imagem Docker.
Instalar
brew install --cask irooftop/tap/irooftop   # macOS
# Windows and Linux: direct downloads under "Download the app" above
# Open the app, then Settings → model and key → Testbrew install irooftop/tap/rooftop
export OPENAI_API_KEY=… # OpenRouter by default, any OpenAI-compatible API works
rooftop # http://127.0.0.1:8080, then drop an export onto the pagedocker run -d -p 8080:8080 -e OPENAI_API_KEY=… \
-v rooftop-data:/data ghcr.io/irooftop/rooftopcargo install rooftop # Rust ≥ 1.88
OPENAI_API_KEY=… rooftopollama pull qwen3 # any local model with tool calling
OPENAI_BASE_URL=http://localhost:11434/v1 OPENAI_MODEL=qwen3 rooftop --offlineDepois, três passos: exporte uma conversa do Telegram Desktop ou do WhatsApp, arraste a pasta, o .zip ou o .txt para a página e clique em New chat para escolher quem faz a IA: a outra pessoa, ou você mesmo. Não tem uma conversa à mão? Experimente as fictícias: rooftop --import ./examples/telegram. (Os nomes dos botões do app estão em inglês, como o próprio app.)
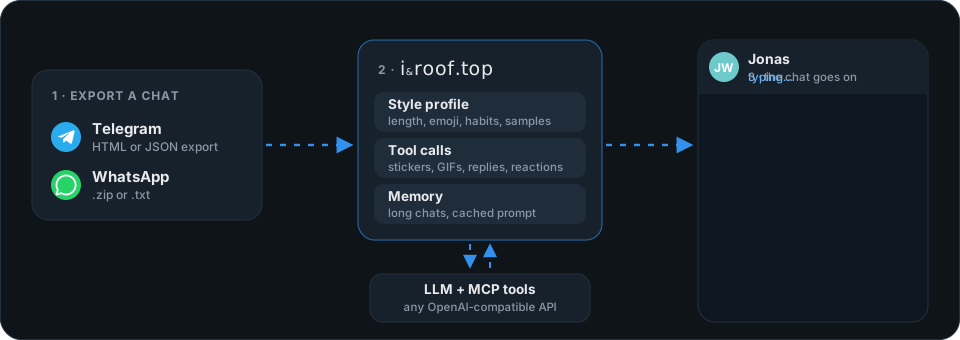
A exportação é lida uma vez, no seu computador. A cada resposta, o modelo recebe um prompt de sistema com o perfil de estilo, as suas notas e as descrições das mídias, e depois a parte mais recente da conversa que cabe no orçamento do histórico. As partes antigas são resumidas numa memória curta, e a persona ainda consegue buscá-las. O modelo responde com chamadas de ferramenta (send_message, send_sticker, react…), que viram bolhas, figurinhas e reações. Mais →
| Rede | |
|---|---|
| Importação, perfil de estilo, busca e armazenamento | nenhuma: tudo acontece no seu computador |
| Uma resposta, um resumo de memória | o endpoint do modelo que você escolher, e mais nada |
| Descrever mídias, transcrever voz | o modelo de mídia, só quando você clica em Describe |
| Links de compartilhamento pela internet, Telegram | só se você os ativar; o modo offline os desliga |
Qualquer modelo de chat com chamada de ferramentas atrás de um endpoint /chat/completions compatível com OpenAI. Modelos maiores imitam melhor um estilo. Para o Describe na biblioteca de mídia, o modelo de mídia também precisa aceitar imagens (e áudio, para mensagens de voz). O Test nas configurações diz, em palavras simples, o que está errado, por exemplo uma chave recusada ou um modelo desconhecido.
Nada com um modelo local. Com um modelo na nuvem, você paga ao seu provedor por token: uma resposta custa cerca de um orçamento de histórico de entrada (120.000 caracteres ≈ 34 mil tokens por padrão; o prompt é montado para ser cacheável, então os provedores com cache de prompt cobram a maior parte pelo preço em cache) mais algumas chamadas curtas de ferramenta. Reduza o orçamento nas configurações para pagar menos por resposta.
Não. Exportações com mais de 120.000 mensagens e 13 GB de mídia são importadas sem problemas, pelo navegador ou com rooftop --import <pasta>. A busca e o orçamento do histórico mantêm o prompt de cada resposta do mesmo tamanho, não importa quão longa seja a conversa.
Pode, com um link de compartilhamento: no seu Wi‑Fi, ou pela internet em nome.iroof.top, com PIN e limites de mensagens. Os visitantes veem só a conversa: nada de configurações, notas, prompts ou outras conversas.
Uma nota sobre cuidado
Isto serve para estar perto de pessoas que estão longe. A persona continua no seu papel, mas responde com honestidade se você perguntar sinceramente se está falando com uma IA, e responde com cuidado se parecer que você está em apuros.