

Sein Stil, nicht nur seine Worte
Ein Stilprofil aus dem ganzen Export, und jede Sprechblase, jeder Sticker, GIF, jede Antwort und Reaktion wird dem Modell als Werkzeugaufruf erneut vorgespielt.
So funktioniert es
Sprich mit den Menschen, die dir fehlen.
Exportiere einen Telegram- oder WhatsApp-Chat, und ein LLM führt ihn im Stil eines Menschen weiter, mit dessen Sprechblasen, Stickern, GIFs, Reaktionen und Stimme. Auf deinem Computer, mit jedem Modell, auf Wunsch offline.
Ein Stilprofil aus dem ganzen Export, und jede Sprechblase, jeder Sticker, GIF, jede Antwort und Reaktion wird dem Modell als Werkzeugaufruf erneut vorgespielt.
So funktioniert es
Chats bleiben in deinem Datenordner. Mit einem lokalen Modell und eingeschaltetem Offline-Modus lehnt die App jede Anfrage ab, die deinen Computer verlassen würde.
Offline & Datenschutz
Über 120.000 Nachrichten und 30.000 Dateien werden mit Live-Fortschritt importiert. Ein erneuter Import wird anhand der Nachrichten erkannt, bevor Medien hochgeladen werden.
Große Exporte
Eine Medienbibliothek, die Gesendetes beschreibt und Sprachnachrichten transkribiert, in der Reihenfolge, die du wählst, und jederzeit stoppbar.
Fotos & Sprache
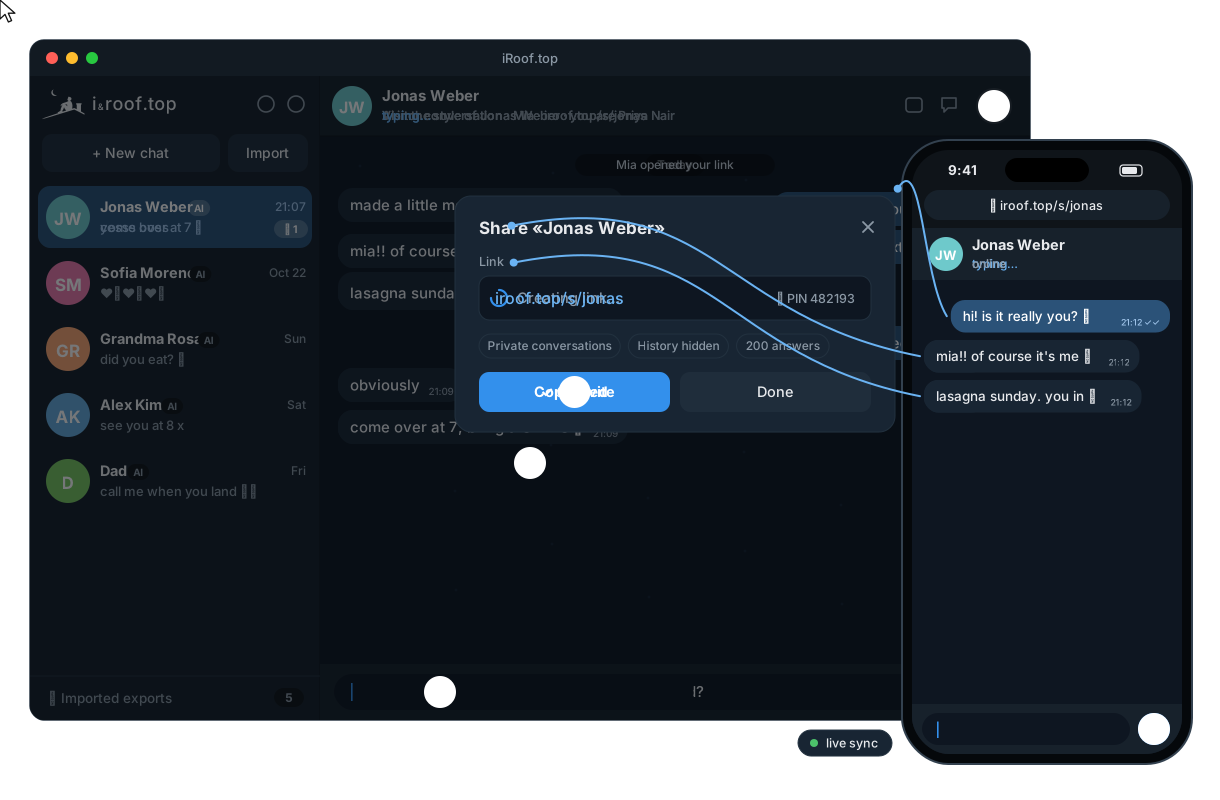
Lass einen Freund unter /s/name mit der Persona sprechen, mit PIN und Grenzen, im WLAN oder unter name.iroof.top.
Freigabelinks
Nachrichten von Besuchern landen in deiner Telegram-Gruppe. Antworte selbst, oder lass die KI nach einem Countdown antworten.
Telegram
OpenAI, OpenRouter, Gemini, Ollama, LM Studio, llama.cpp… dazu MCP-Werkzeuge über Streamable HTTP oder stdio.
MCP-Werkzeuge
Das genaue JSON an das Modell ist einen Klick entfernt, mit Größe, Verlaufsbudget und verbrauchten Tokens.
Was im Fenster steht
Ein Rust-Server mit eingebauter Weboberfläche, Desktop-Apps für macOS, Windows und Linux, Homebrew und ein Docker-Image.
Installieren
brew install --cask irooftop/tap/irooftop   # macOS
# Windows and Linux: direct downloads under "Download the app" above
# Open the app, then Settings → model and key → Testbrew install irooftop/tap/rooftop
export OPENAI_API_KEY=… # OpenRouter by default, any OpenAI-compatible API works
rooftop # http://127.0.0.1:8080, then drop an export onto the pagedocker run -d -p 8080:8080 -e OPENAI_API_KEY=… \
-v rooftop-data:/data ghcr.io/irooftop/rooftopcargo install rooftop # Rust ≥ 1.88
OPENAI_API_KEY=… rooftopollama pull qwen3 # any local model with tool calling
OPENAI_BASE_URL=http://localhost:11434/v1 OPENAI_MODEL=qwen3 rooftop --offlineDann drei Schritte: Chat exportieren aus Telegram Desktop oder WhatsApp, Ordner, .zip oder .txt auf die Seite ziehen und New chat drücken, um zu wählen, wer die KI spielt: die andere Person oder du selbst. Kein eigener Chat zur Hand? Probiere die fiktiven aus: rooftop --import ./examples/telegram. (Die Beschriftungen der App sind auf Englisch, wie die App selbst.)
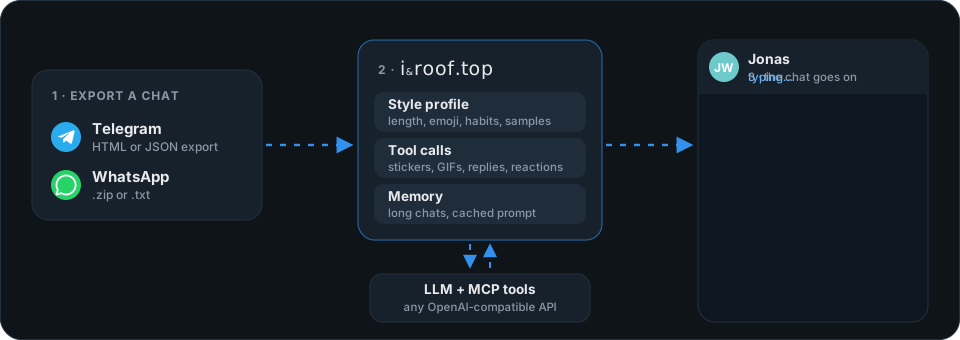
Der Export wird einmal auf deinem Computer gelesen. Bei jeder Antwort bekommt das Modell einen Systemprompt mit dem Stilprofil, deinen Notizen und den Medienbeschreibungen, dann den neuesten Teil des Chats, der ins Verlaufsbudget passt. Ältere Teile werden zu einer kurzen Erinnerung zusammengefasst, und die Persona kann sie weiterhin durchsuchen. Das Modell antwortet mit Werkzeugaufrufen (send_message, send_sticker, react…), die zu Sprechblasen, Stickern und Reaktionen werden. Mehr →
| Netzwerk | |
|---|---|
| Import, Stilprofil, Suche, Speicher | keins: alles passiert auf deinem Computer |
| Eine Antwort, eine Speicherzusammenfassung | der Modellendpunkt deiner Wahl, und sonst nichts |
| Medien beschreiben, Sprache transkribieren | das Medienmodell, nur wenn du Describe drückst |
| Freigabelinks über das Internet, Telegram | nur wenn du sie einschaltest; der Offline-Modus schaltet sie ab |
Jedes Chat-Modell mit Werkzeugaufrufen hinter einem OpenAI-kompatiblen Endpunkt /chat/completions. Größere Modelle imitieren einen Stil besser. Für Describe in der Medienbibliothek muss das Medienmodell außerdem Bilder akzeptieren (und Audio für Sprachnachrichten). Test in den Einstellungen sagt in einfachen Worten, was nicht stimmt, etwa ein abgelehnter Schlüssel oder ein unbekanntes Modell.
Mit einem lokalen Modell nichts. Mit einem Cloud-Modell zahlst du deinem Anbieter pro Token: Eine Antwort kostet ungefähr ein Verlaufsbudget an Eingabe (standardmäßig 120.000 Zeichen ≈ 34.000 Tokens; der Prompt ist so aufgebaut, dass er cachebar ist, daher berechnen Anbieter mit Prompt-Caching den größten Teil zum Cache-Preis), dazu einige kurze Werkzeugaufrufe. Senke das Budget in den Einstellungen, um pro Antwort weniger zu zahlen.
Nein. Exporte mit über 120.000 Nachrichten und 13 GB Medien lassen sich importieren, aus dem Browser oder mit rooftop --import <Ordner>. Suche und Verlaufsbudget halten die Größe des Prompts jeder Antwort gleich, egal wie lang der Chat ist.
Ja, mit einem Freigabelink: im WLAN oder über das Internet unter name.iroof.top, mit PIN und Nachrichtenlimits. Besucher sehen nur den Chat: keine Einstellungen, Notizen, Prompts oder anderen Chats.
Ein Hinweis zur Fürsorge
Das ist dafür da, denen nahe zu bleiben, die weit weg sind. Die Persona bleibt in ihrer Rolle, antwortet aber ehrlich, wenn du ernsthaft fragst, ob du mit einer KI sprichst, und sie reagiert behutsam, wenn du in Not zu sein scheinst.