

So funktioniert es
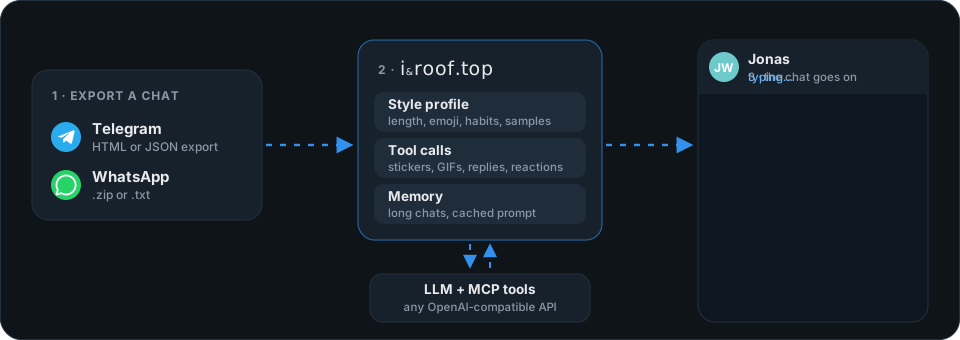
Jeder Export wird zu denselben normalisierten Nachrichten. Dann wird jede Aktion der Person dem Modell als Tool-Aufruf vorgespielt, damit es lernt, wie die Person interagiert, nicht nur, was sie schreibt, und genauso antwortet.
Aktionen als Tool-Aufrufe
| Was die Person getan hat | Tool-Aufruf im Verlauf und in Live-Antworten |
|---|---|
| Textblase, vielleicht eine Antwort oder ein Teilzitat | send_message {text, reply_to?, quote?} |
| Sticker | send_sticker {sticker_id, reply_to?} |
| GIF aus der Bibliothek, oder eine URL von einem MCP-Tool | send_gif {gif_id | url, caption?} |
| Foto, Video, Sprache, Audio, Datei | send_media {media_id, caption?} |
| weitergeleiteter Beitrag | forward_message {message_id} |
| Reaktion | react {message_id, emoji} |
| (älteren Verlauf abrufen) | search_history {query} |
Mehrere Aufrufe in einem Zug werden zu mehreren Blasen. Die Nachrichten der Gegenseite werden zu kompakten Zeilen, auf die sich die IDs beziehen:
#52108 19:08 ↩ Antwort auf #52107 (du: "Omas Lasagne 🍝"): Du hast noch nie Lasagne gemacht.
<sticker stk_156dbb381a>: eine Katze mit Kochmütze, die in einem Topf rührt
reagiert 😂 auf #52107 ("Omas Lasagne 🍝")
Der Systemprompt
| Teil | |
|---|---|
| Wer sein soll | schätzt Wissen und Stil der Person und weiß nie mehr, als sie wüsste |
| Stilprofil | aus dem gesamten Export: Nachrichtenlänge, Groß- und Kleinschreibung, Zeichensetzung, Emoji- und Sticker-Nutzung, Antwort- und Reaktionsgewohnheiten, Blasen pro Zug, wörtliche Beispiele |
| Bibliothek | Sticker, GIFs und Medien mit ihrer Verwendung |
| Notizen | was du über die Person geschrieben hast |
Der Prompt ist für einen Chat statisch: keine Uhr, keine Zähler. Das Modell liest die Zeit aus den — Tag —-Trennern und den HH:MM-Stempeln, und jede Anfrage ist ein byteidentisches Präfix der nächsten, sodass die Prompt-Caches der Anbieter weiter treffen.
Lange Chats
 Verlaufsbudget ────────────────────────────────────────────────▶
 ┌──────────────────────┬────────────────────────────────────────┐
 │ Gedächtnis (≤ 350 W.)│ neueste Züge, auf 60 % des Budgets gekürzt │
 └──────────────────────┴────────────────────────────────────────┘
   Beziehung, Fakten,      der Schnittpunkt bleibt lange stehen,
   Themen, Insider         so bleibt auch das gecachte Präfix
Wenn der wiedergegebene Verlauf das Budget übersteigt, fasst die nächste Antwort zuerst die ältesten Züge (und das bisherige Gedächtnis) zu einer kurzen Zusammenfassung zusammen. Beim Import und beim Öffnen eines Chats wird nichts verbraucht. Das Stilprofil stammt weiterhin aus dem gesamten Export, und search_history erreicht jede alte Nachricht. Die Token-usage (Prompt, Cache, Vervollständigung) wird in { } angezeigt.
Medienbibliothek
Das Chatmodell liest Text, also ist ein Sticker nur <sticker stk_…>, bis es beschrieben ist. Mit KI beschreiben sendet die Bilder der fehlenden Einträge an das Medienmodell, das Vision unterstützen muss.
- GIFs, Video-Sticker und Videos gehen als 4 Bilder in Reihenfolge, damit das Modell die Bewegung sieht. Dafür braucht es ffmpeg (
brew install ffmpeg,apt install ffmpeg,winget install ffmpeg), sonst wird das Vorschaubild verwendet. - Neu beschreibt einen Eintrag erneut. Jede Beschreibung kann von Hand bearbeitet werden.
- Beschreibungen gehören zum Export und gelten für alle seine Chats.
Probier es selbst mit der CLI aus: rooftop convert <Export> --persona "Jonas Weber".