

Como funciona
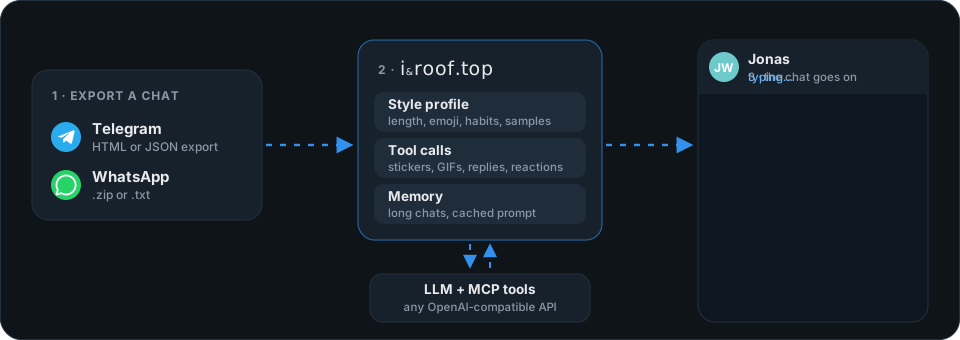
Cada exportação vira as mesmas mensagens normalizadas. Depois, cada ação da persona é reproduzida ao modelo como uma chamada de ferramenta, para que ele aprenda como a pessoa interage, não apenas o que ela escreve, e responda do mesmo jeito.
Ações como chamadas de ferramentas
| O que a persona fez | Chamada de ferramenta no histórico e nas respostas ao vivo |
|---|---|
| balão de texto, talvez uma resposta ou uma citação parcial | send_message {text, reply_to?, quote?} |
| figurinha | send_sticker {sticker_id, reply_to?} |
| GIF da biblioteca, ou uma URL de uma ferramenta MCP | send_gif {gif_id | url, caption?} |
| foto, vídeo, voz, áudio, arquivo | send_media {media_id, caption?} |
| publicação encaminhada | forward_message {message_id} |
| reação | react {message_id, emoji} |
| (lembrar um histórico antigo) | search_history {query} |
Várias chamadas em um turno viram vários balões. As mensagens do outro lado viram linhas compactas às quais os ids se referem:
#52108 19:08 ↩ resposta a #52107 (você: "lasanha da vovó 🍝"): Você nunca fez lasanha, nenhuma vez.
<sticker stk_156dbb381a>: um gato de chapéu de cozinheiro mexendo uma panela
reagiu 😂 a #52107 ("lasanha da vovó 🍝")
O prompt do sistema
| Parte | |
|---|---|
| Quem ser | estimar o conhecimento e o estilo da persona, e nunca saber mais do que ela saberia |
| Perfil de estilo | da exportação inteira: tamanho das mensagens, maiúsculas, pontuação, uso de emoji e figurinhas, hábitos de resposta e reação, balões por turno, amostras literais |
| Biblioteca | figurinhas, GIFs e mídia com como foram usados |
| Notas | o que você escreveu sobre a pessoa |
O prompt é estático para um chat: sem relógio, sem contadores. O modelo lê a hora pelos separadores — dia — e pelos carimbos HH:MM, e cada requisição é um prefixo idêntico, byte a byte, da seguinte, então os caches de prompt dos provedores continuam acertando.
Chats longos
 orçamento do histórico ──────────────────────────────────────▶
 ┌──────────────────────┬────────────────────────────────────────┐
 │ memória (≤ 350 pal.) │ turnos recentes, cortados em 60 %      │
 └──────────────────────┴────────────────────────────────────────┘
   relação, fatos,        o ponto de corte fica parado por muito
   temas, piadas          tempo, então o prefixo em cache também
Quando o histórico reproduzido ultrapassa o orçamento, a próxima resposta primeiro resume os turnos mais antigos (e a memória anterior) em um resumo curto. Nada é gasto na importação nem ao abrir um chat. O perfil de estilo ainda vem da exportação inteira, e o search_history alcança cada mensagem antiga. O usage de tokens (prompt, em cache, conclusão) é mostrado em { }.
Biblioteca de mídia
O modelo de chat lê texto, então uma figurinha é só <sticker stk_…> até ser descrita. Descrever com IA envia as imagens dos itens que faltam ao modelo de mídia, que precisa suportar visão.
- GIFs, figurinhas em vídeo e vídeos são enviados como 4 quadros em ordem, para que o modelo veja o movimento. Isso precisa do ffmpeg (
brew install ffmpeg,apt install ffmpeg,winget install ffmpeg); do contrário, a miniatura é usada. - Refazer descreve um item de novo. Qualquer descrição pode ser editada à mão.
- As descrições pertencem à exportação e servem a todos os seus chats.
Veja você mesmo com a CLI: rooftop convert <exportação> --persona "Jonas Weber".