

仕組み
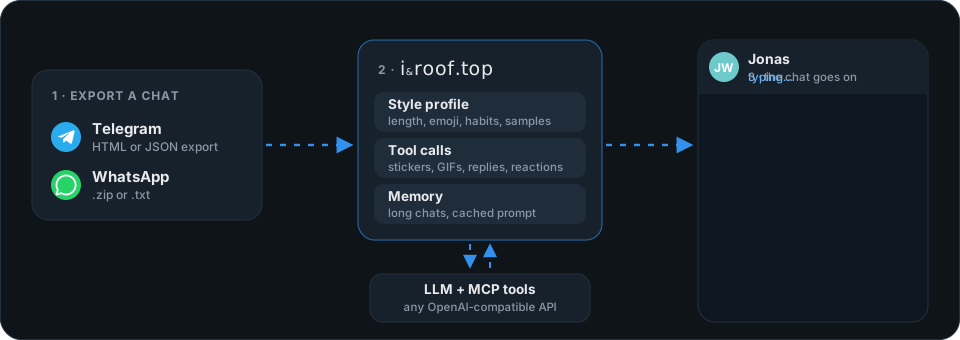
どのエクスポートも、同じ正規化されたメッセージになります。その後、ペルソナのすべての行動がツール呼び出しとしてモデルに再生されます。そうすることでモデルは、何を書くかだけでなく、その人がどのようにやり取りするかを学び、同じように答えます。
行動をツール呼び出しとして
| ペルソナがしたこと | 履歴とライブ応答でのツール呼び出し |
|---|---|
| テキストの吹き出し(返信や部分引用を伴うことも) | send_message {text, reply_to?, quote?} |
| スタンプ | send_sticker {sticker_id, reply_to?} |
| ライブラリの GIF、または MCP ツールの URL | send_gif {gif_id | url, caption?} |
| 写真、動画、ボイス、音声、ファイル | send_media {media_id, caption?} |
| 転送された投稿 | forward_message {message_id} |
| リアクション | react {message_id, emoji} |
| (古い履歴を思い出す) | search_history {query} |
1 回のターンで複数の呼び出しを行えば、複数の吹き出しになります。相手側のメッセージは、ID が参照するコンパクトな行になります。
text
#52108 19:08 ↩ #52107 への返信(あなた:「おばあちゃんのラザニア 🍝」):あなたは一度もラザニアを作ったことがないでしょう。
<sticker stk_156dbb381a>:コック帽をかぶった猫が鍋をかき混ぜている
#52107(「おばあちゃんのラザニア 🍝」)に 😂 のリアクション
システムプロンプト
| 部分 | |
|---|---|
| なるべき人物 | ペルソナの知識と文体を推定し、本人が知り得る以上のことは決して知らない |
| スタイルプロファイル | エクスポート全体から:メッセージの長さ、大文字、句読点、絵文字とスタンプの使い方、返信とリアクションの習慣、ターンあたりの吹き出し数、逐語的なサンプル |
| ライブラリ | スタンプ、GIF、メディアと、それがどう使われたか |
| メモ | あなたがその人について書いたこと |
プロンプトはチャットごとに静的です。時計もカウンターもありません。モデルは — 日 — の区切りと HH:MM のタイムスタンプから時刻を読み取ります。各リクエストは次のリクエストのバイト単位で同一の接頭辞になるので、プロバイダーのプロンプトキャッシュが効き続けます。
長いチャット
 履歴の予算 ─────────────────────────────────────────────────▶
 ┌──────────────────────┬────────────────────────────────────────┐
 │ メモリ(350 語以内) │ 最新のターン(予算の 60 % に切り詰め) │
 └──────────────────────┴────────────────────────────────────────┘
   関係性、事実、        切り詰めの位置は長く動かないため、
話題、お決まりの冗談 キャッシュされた接頭辞も保たれる再生される履歴が予算を超えると、次の返信は、まず最も古いターン(と以前のメモリ)を短い要約にまとめます。インポートやチャットを開くときには何も消費されません。スタイルプロファイルは引き続きエクスポート全体から作られ、search_history はすべての古いメッセージに届きます。トークンの usage(プロンプト、キャッシュ、補完)は { } に表示されます。
メディアライブラリ
チャットモデルはテキストを読むので、スタンプは説明されるまでは <sticker stk_…> にすぎません。AI で説明は、不足している項目の画像をメディアモデルに送ります。メディアモデルは画像認識に対応している必要があります。
- GIF、ビデオスタンプ、動画は 4 フレームを順番に送られるので、モデルは動きを見られます。これには ffmpeg(
brew install ffmpeg、apt install ffmpeg、winget install ffmpeg)が必要です。ない場合はサムネイルが使われます。 - やり直すは、1 つの項目をもう一度説明します。どの説明も手で編集できます。
- 説明はエクスポートに属し、そのすべてのチャットで使われます。
CLI で自分で試せます:rooftop convert <エクスポート> --persona "Jonas Weber"。