

工作原理
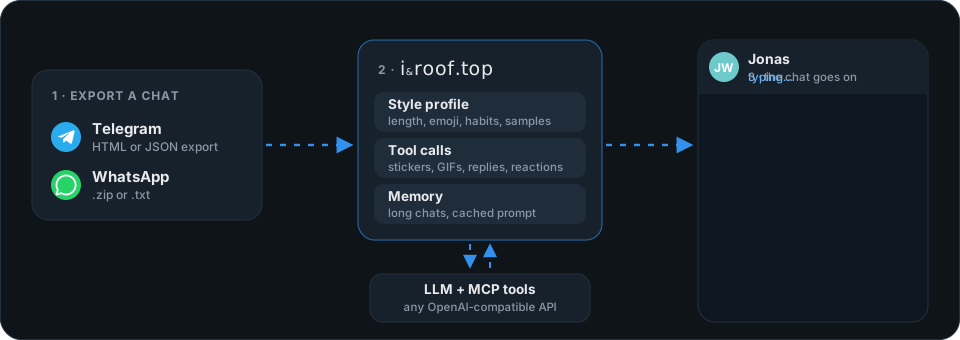
每个导出都会变成相同的规范化消息。然后,角色的每个动作都会作为工具调用重放给模型,让模型学习这个人如何互动,而不仅仅是他写了什么,并以相同的方式回应。
将动作表示为工具调用
| 角色所做的事 | 历史记录和实时回复中的工具调用 |
|---|---|
| 文字气泡,可能带有回复或部分引用 | send_message {text, reply_to?, quote?} |
| 贴纸 | send_sticker {sticker_id, reply_to?} |
| 媒体库中的 GIF,或来自 MCP 工具的 URL | send_gif {gif_id | url, caption?} |
| 照片、视频、语音、音频、文件 | send_media {media_id, caption?} |
| 转发的帖子 | forward_message {message_id} |
| 表情回应 | react {message_id, emoji} |
| (回忆更早的历史) | search_history {query} |
一个回合中的多次调用会变成多个气泡。另一方的消息会变成紧凑的行,ID 指向这些行:
text
#52108 19:08 ↩ 回复 #52107(你:“奶奶的千层面 🍝”):你从来没有做过一次千层面。
<sticker stk_156dbb381a>:一只戴着厨师帽的猫在搅拌锅子
对 #52107(“奶奶的千层面 🍝”)回应了 😂
系统提示词
| 部分 | |
|---|---|
| 应该扮演谁 | 推断角色的知识和风格,并且永远不知道超出其本人所知的内容 |
| 风格档案 | 来自整个导出:消息长度、大小写、标点、表情和贴纸的使用、回复和回应的习惯、每回合的气泡数、逐字样本 |
| 媒体库 | 贴纸、GIF 和媒体,以及它们被如何使用 |
| 笔记 | 你写下的关于这个人的内容 |
对于一个聊天,提示词是静态的:没有时钟,没有计数器。模型从 — 日期 — 分隔符和 HH:MM 时间戳中读取时间,每个请求都是下一个请求的逐字节相同的前缀,因此提供商的提示词缓存能持续命中。
长聊天
 历史预算 ─────────────────────────────────────────────────▶
 ┌──────────────────────┬────────────────────────────────────────┐
 │ 记忆(≤ 350 词)     │ 最近的回合,裁剪到预算的 60 %           │
 └──────────────────────┴────────────────────────────────────────┘
   关系、事实、          裁剪点会长时间保持不变,
   话题、玩笑            因此被缓存的前缀也保持不变
当重放的历史超过预算时,下一次回复会先把最早的回合(以及之前的记忆)压缩成一段简短的摘要。导入和打开聊天时都不会消耗任何资源。风格档案仍然来自整个导出,而 search_history 可以访问每一条旧消息。token 的 usage(提示、缓存、补全)会显示在 { } 中。
媒体库
聊天模型读取的是文本,所以在被描述之前,贴纸只是 <sticker stk_…>。用 AI 描述会把缺少描述的项目的图像发送给媒体模型,该模型必须支持视觉。
- GIF、视频贴纸和视频会以按顺序的 4 帧发送,这样模型能看到动作。这需要 ffmpeg(
brew install ffmpeg、apt install ffmpeg、winget install ffmpeg),否则会使用缩略图。 - 重新描述会对一个项目重新生成描述。任何描述都可以手动编辑。
- 描述属于导出,并服务于它的所有聊天。
可以用 CLI 自己查看:rooftop convert <导出> --persona "Jonas Weber"。